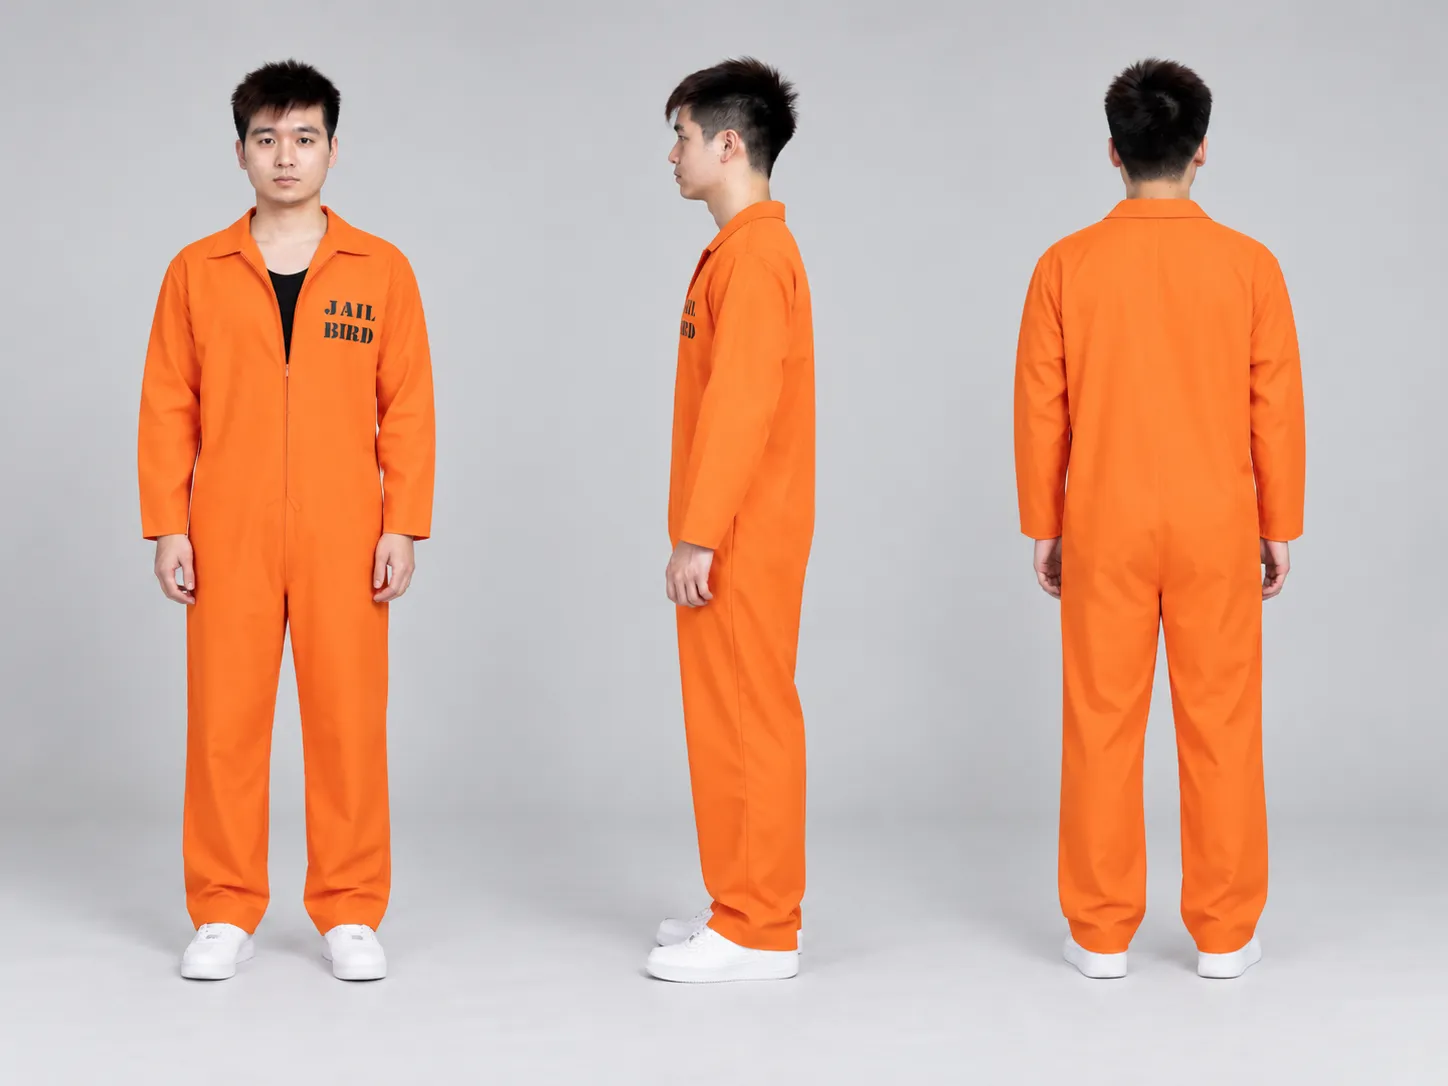
萬聖節快到了,你想好今年要 Cosplay 甚麼角色了嗎?
看到網店的造型照片,可能覺得很好看,但換成自己穿上,又會是甚麼效果?今次我用 ChatGPT 做了一個虛擬試衣示範:先建立自己的人物參考圖,再配合服裝圖片,生成正面、側面和背面的造型預覽。
不用先買一套衣服回來,也可以看看自己穿上後的大概感覺。
第一步:準備自己的三個角度照片
先準備自己的正面、側面和背面照片,再上傳到 ChatGPT,請它整理成一張三視圖人物參考圖。
這張圖的用途,是讓之後的換裝有一個統一的人物參考:五官、髮型、膚色和身體比例,都盡量保持一致。
拍攝時,建議穿同一套衣服,在光線充足的地方自然站立,並讓頭部到鞋履完整入鏡。三張照片的拍攝距離和鏡頭高度,也盡量保持相近。
我今次提供的原相沒有完整拍到雙腳,因此生成圖中的鞋履與部分下半身細節,包含 AI 的補全。大家自己拍攝時,可以預留多一點空間,減少需要 AI 猜測的地方。
第二步:找一套想試穿的服裝
建立人物參考圖後,就可以在淘寶或其他網店找想試穿的服裝。
今次我用的是一套橙色連身囚服,胸前印有「JAIL BIRD」字樣。我準備了服裝正背面的商品圖,以及一張模特兒穿搭照。
這兩種圖片各有用途:商品圖用來看衣服的剪裁、顏色和圖案;穿搭照則可以參考領口開合、內搭和配件。
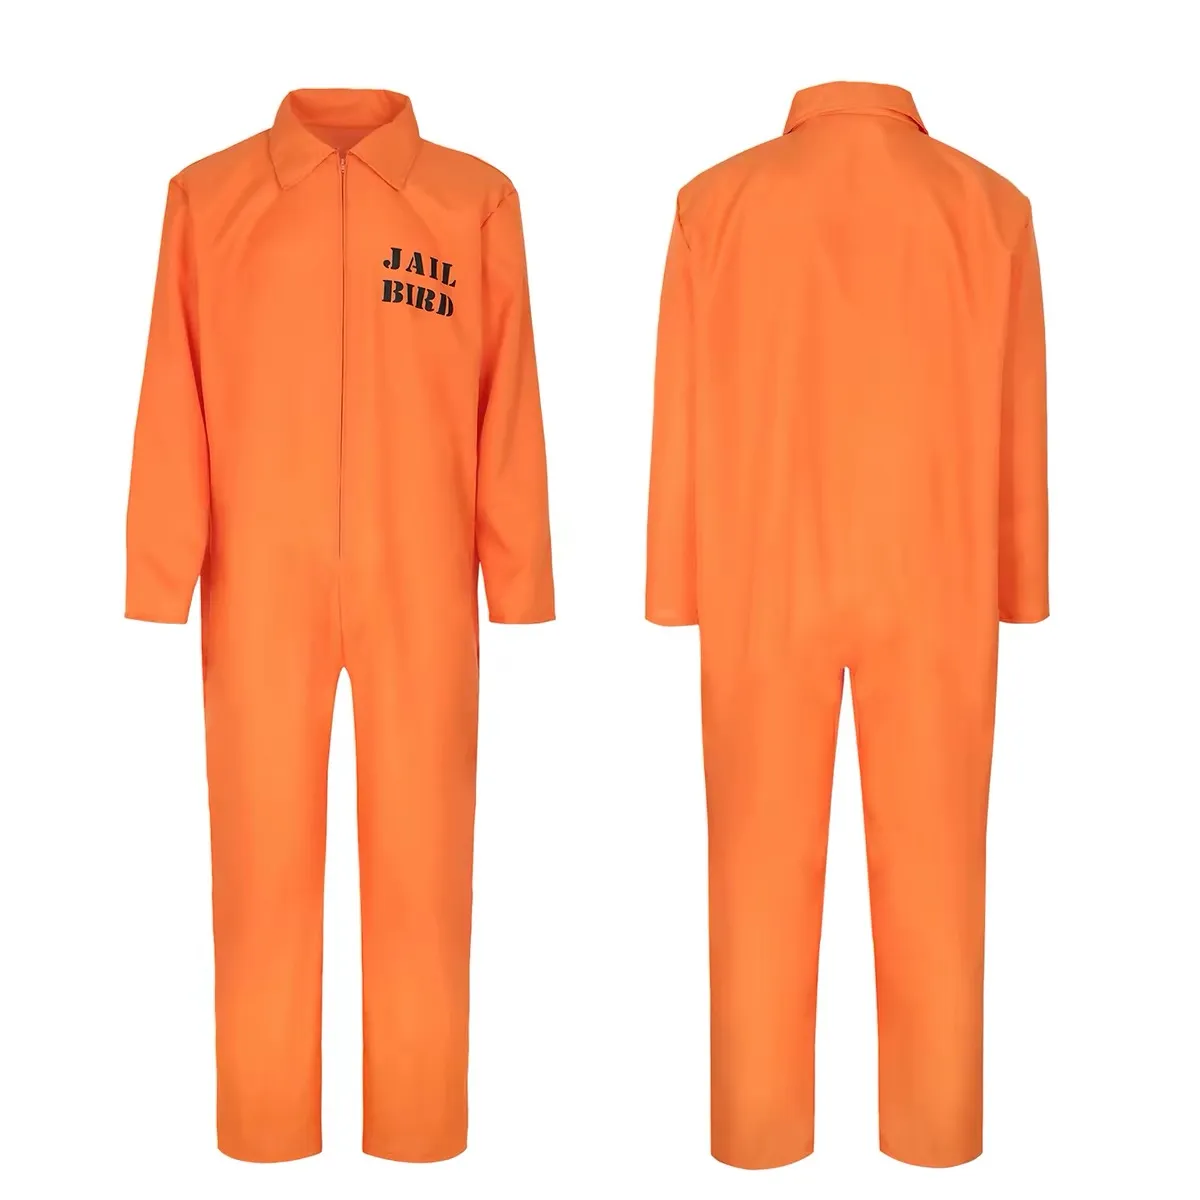
換裝時,要清楚告訴 ChatGPT:人物外貌以自己的照片為準,服裝圖片只用來參考衣服和穿搭。 否則,生成結果可能連模特兒的面貌或身形都一併混入。
第三步:生成三視圖試穿效果
接着,把人物參考圖和服裝圖片一起上傳,再輸入換裝 Prompt。
我要求它把同一套衣服穿在同一個人物身上,並排展示正面、側面和背面,配合簡單的淺灰色背景,方便集中看整體造型。
以下就是今次的生成成果:
圖中可以看到橙色連身衣、胸前字樣和黑色內搭,也能從側面與背面觀察整體輪廓。
不過,穿搭參考照中的頸鏈和手銬沒有出現在這張成果圖,而白色波鞋也不是由原相完整提供的細節。這提醒我們:如果某件配件是造型重點,最好在 Prompt 中逐項寫明,生成後再對照檢查。
先看造型,再決定怎樣配搭
我平時也會用 ChatGPT 圖像生成來嘗試不同造型。這次萬聖節示範,最實用的地方,就是可以先看看某套衣服配上自己的外貌,大概呈現甚麼感覺。
這類圖片適合用來預覽配色和造型方向;實際衣服的尺碼、鬆緊和布料質感,仍要看商品資料及真正試穿。
下面整理了兩段可以直接複製使用的 Prompt。先建立自己的人物參考圖,再換上想試的服裝,就可以沿用這個流程嘗試其他造型。
Prompt 1:建立個人三視圖參考圖
使用方法: 上傳自己的正面、側面及背面照片,再貼上以下內容。最好使用頭部至鞋履完整入鏡的照片。
請根據我上傳的正面、側面及背面真人照片,生成一張寫實的三視圖人物參考圖,供日後 AI 虛擬試衣使用。

【參考資料與優先次序】
所有照片都是同一個人,並且是唯一的人物身份參考。
正面照片主要提供五官與正面輪廓;側面及背面照片補充頭形、髮型與身體輪廓。
不同角度應整合成同一人物,不要生成三個外貌相似但不同的人。

【人物要求】
盡量保留原本的五官、面型、髮型、膚色,以及照片可見的自然體型與身體比例。
不要美化、磨皮、瘦身、增肌、拉長雙腿或改變年齡感。
保留原相的衣服與鞋履,不要自行更換造型。
移除手持物件,雙手自然垂下,避免遮擋身體輪廓。

如果照片裁掉腳部或缺少關鍵身體部位,請先指出需要補拍的位置,並等待我補充;不要把猜測的部分當成真實人物資料。

【構圖】
生成一張橫向圖片,三個全身視角由左至右並排:
左:正面,面向鏡頭。
中:90 度側面,面向畫面左方。
右:背面,背向鏡頭。

三個視角保持相同的人物比例、畫面內高度、鏡頭高度及拍攝距離。
雙腳站在同一水平基線,人物之間留有空間,不要重疊。
頭頂、雙手及鞋底完整入鏡,四周預留少量空間。
自然站姿,不要擺時裝模特兒姿勢。

【背景與畫質】
簡潔淺灰色攝影棚背景,柔和均勻的燈光。
保留自然皮膚質感,避免廣角變形、誇張透視或過度修圖。
不添加其他人物、道具、裝飾、文字或浮水印。

Photorealistic full-body reference photography,
consistent identity across three views,
natural body proportions, neutral studio lighting.

資料足夠時,請直接生成一張三視圖參考圖。
Prompt 2:換上指定服裝
使用方法: 上傳人物參考圖作為圖片 A、服裝商品圖作為圖片 B。如有模特兒穿搭照,可以一併上傳作為圖片 C。
請根據我上傳的參考圖片,生成一張 AI 虛擬試衣三視圖。

【圖片分工】
圖片 A:人物參考圖。
這是唯一的人物身份與身體比例依據。

圖片 B:服裝商品圖。
用來參考服裝的顏色、剪裁、長度、圖案、拉鏈、口袋及其他可見細節。

圖片 C(如有):穿搭示範圖。
只用來補充領口開合、內搭及配件的穿搭方式。
不要複製圖中模特兒的五官、髮型、膚色、身形、姿勢或背景。

如服裝資料互相矛盾,衣服本身的設計以圖片 B 為準,穿搭方式以我以下的補充要求為準。

【本次補充要求】
內搭:依穿搭示範圖;沒有示範則不要自行添加。
鞋履:服裝參考有清楚展示則採用;否則保留圖片 A 的鞋履。
配件:只加入服裝或穿搭參考圖中清楚可見的穿戴配件,不加入場景道具。
其他指定要求:無。

【換裝要求】
1. 將指定服裝穿在圖片 A 的人物身上,盡量保留其五官、面型、髮型、膚色、自然體型及身體比例。
2. 不要為了配合服裝而瘦身、增肌、拉長雙腿或改變人物外貌。
3. 根據參考圖片呈現合理的布料垂墜、摺痕與鬆緊感。
4. 衣服上的可辨識文字與圖案,盡量保留原本內容、位置及方向,不要鏡像或自行新增。
5. 已提供正面或背面資料的部分,請依照圖片還原。
6. 未顯示的側面或背面,只作保守、簡潔且符合服裝結構的推測,不要新增標誌、圖案、口袋或裝飾。
7. 三個視角的領口開合、內搭、袖長、褲長、配件及鞋履必須一致。

【輸出構圖】
生成一張橫向圖片,由左至右並排展示:
左:正面。
中:90 度側面,面向畫面左方。
右:背面。

三個視角必須是同一人物、同一套服裝與同一種穿搭方式。
保持自然站姿,雙手自然垂下。
人物在畫面內的高度、拍攝距離與地面基線一致。
頭頂至鞋底完整入鏡,各視角互不重疊。
使用一致的淺灰色攝影棚背景及柔和均勻燈光。
不要添加文字標籤、裝飾或浮水印。

Photorealistic virtual try-on,
consistent facial identity and outfit across three views,
natural fabric drape, realistic body proportions,
clean studio lighting.

請直接生成一張三視圖試穿效果圖,不需要額外文字說明。以今次囚服示範為例,可以將「本次補充要求」改成:黑色內搭、領口稍微打開、白色波鞋、不加頸鏈及手銬。 這樣就更清楚指定了最終想要的造型。